AI声音克隆全流程实操,3秒极速复刻、模型预训练、Cosyvoice云端部署
- 4.8K 次浏览
AI声音克隆课,用Cosyvoice讲声音克隆的完整流程,一共4节:基础概念入门、3秒极速复刻、模型预训练、云端部署Cosyvoice,附软件,想快速上手声音克隆的可以跟着学
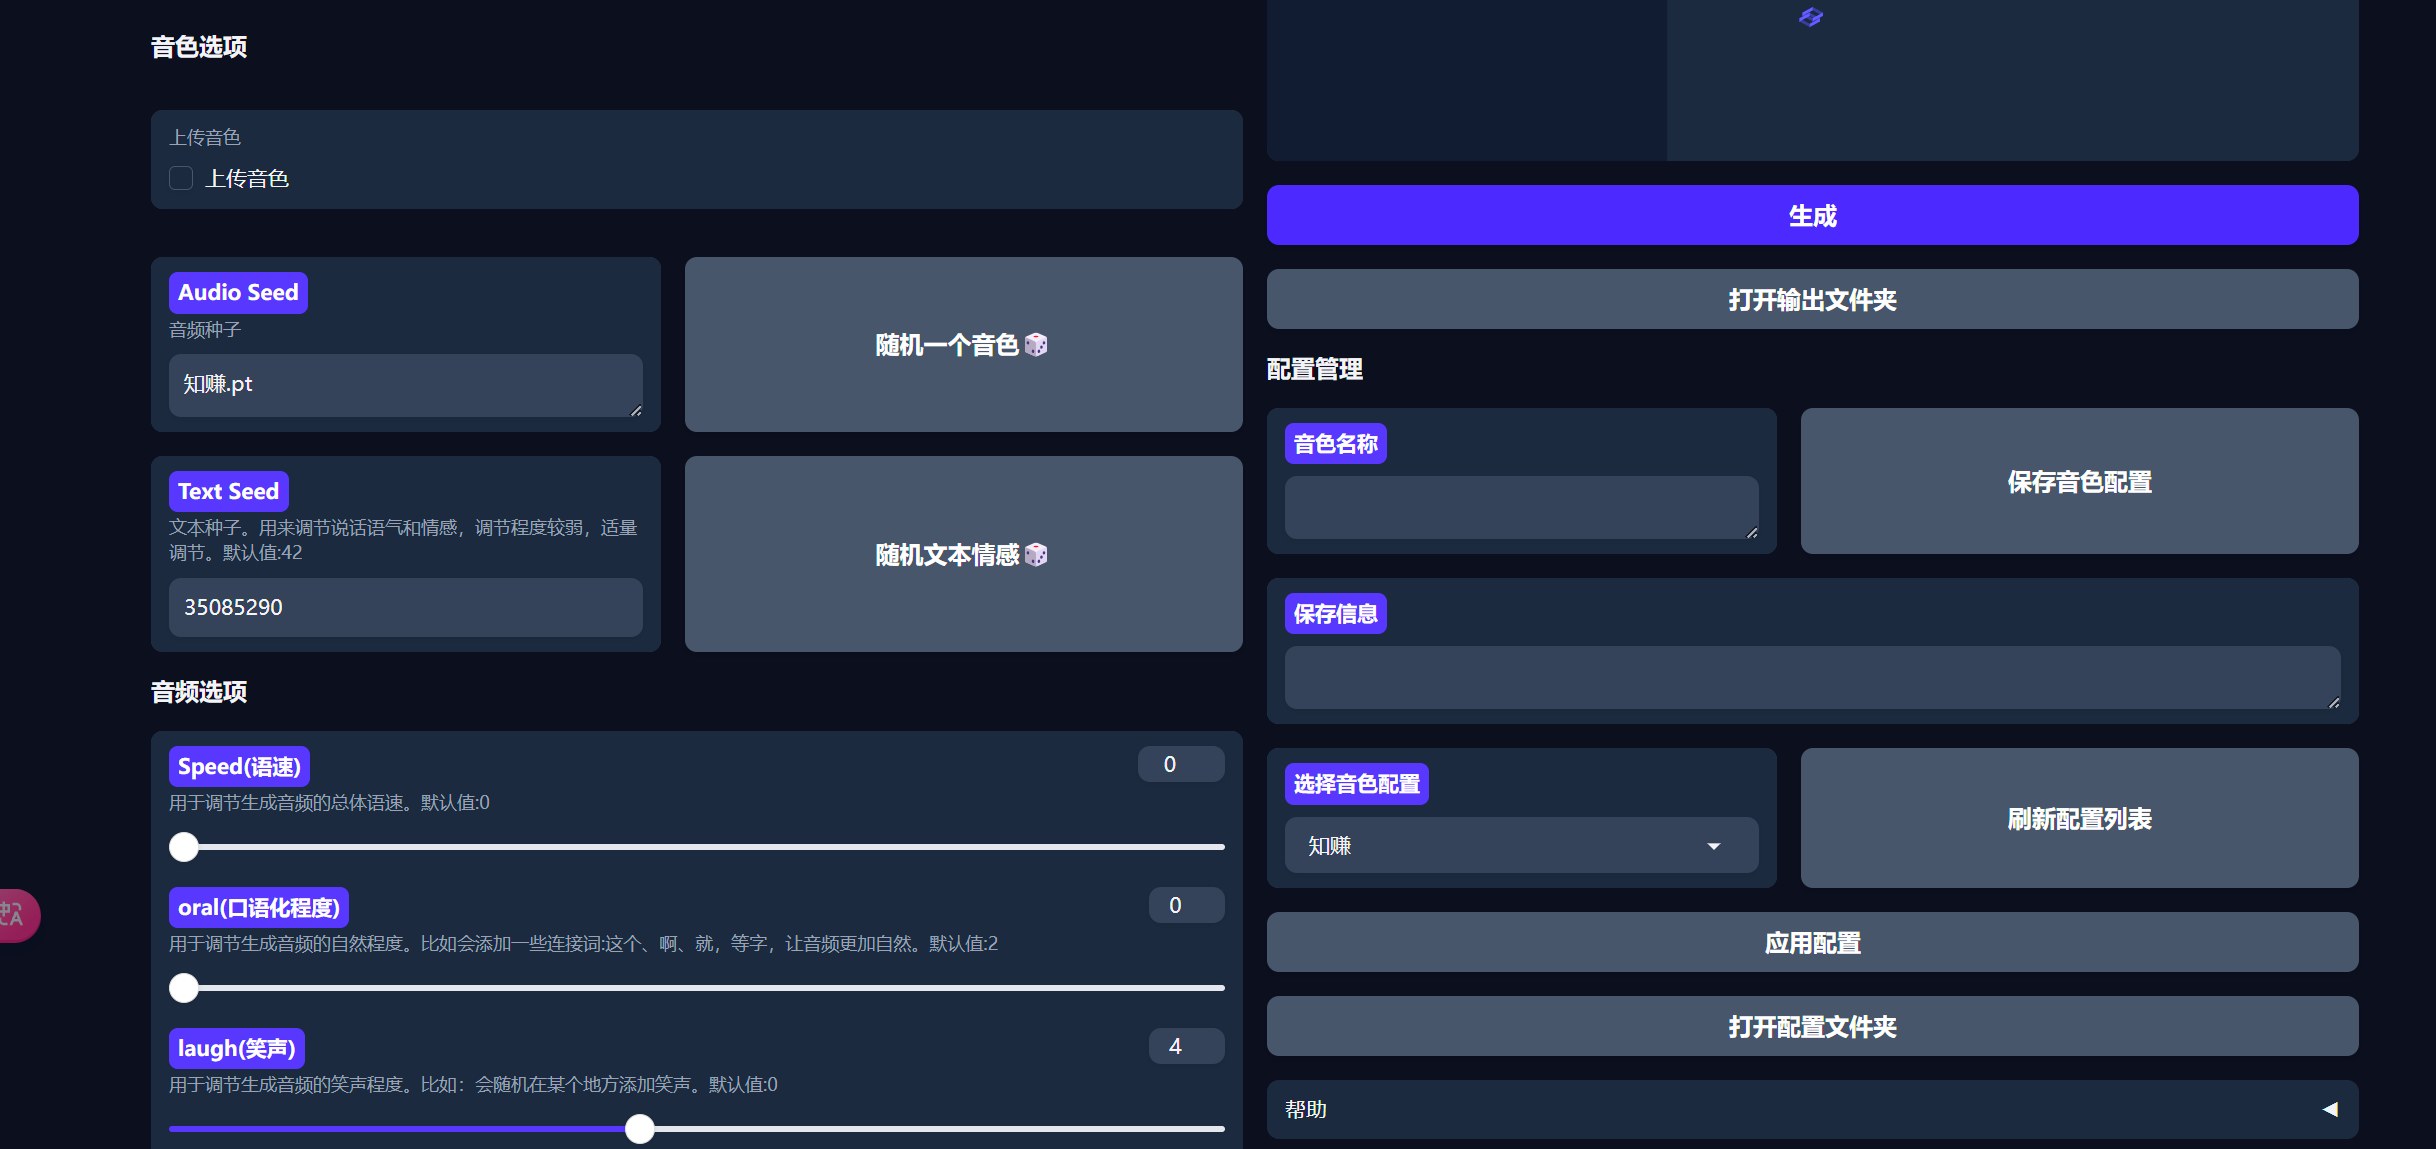
AI 声音克隆的门槛这两年降得很低,一段几秒钟的录音就能让模型学会一个音色,再拿它去念任意文本。这门课围绕 CosyVoice 这个开源语音模型展开,从基础概念讲到声音复刻、模型预训练,最后落到云端部署
3 秒复刻是怎么做到的
零样本声音克隆不需要提前录几十分钟语料,只要给模型一段干净的参考音频,它就能从中提取音色特征,后面合成时沿用这个音色。课程里讲的「3 秒极速复刻」走的正是这条路线
要做到像,参考音频的质量比时长更要紧:环境安静、没有混响和背景音乐、语速平稳,出来的音色就更接近原声。这一节会演示从录音到克隆出效果的完整操作
模型预训练解决什么问题
只用一段参考音频,音色虽然像,但长文本的稳定性和语气变化会差一些。预训练是拿更多目标音色的数据去调模型,让它在长句、多语种、情绪起伏上更稳
这一步涉及数据量、音频切分和训练参数,课程把它们放在同一节里过一遍,跟着做就能跑通
把 CosyVoice 部署到云端
本地跑语音模型,瓶颈一般在显卡。部署这一节讲的是把 CosyVoice 放到带 GPU 的云服务器上:配 Python 环境、拉取模型文件、启动 WebUI 或接口服务,之后在浏览器里就能调用
云端按小时计费,不用了关机就行,比直接买显卡省事。这部分以命令行操作为主,命令照着复制粘贴即可
适合谁看
- 想用自己的音色给视频配音的自媒体作者
- 做口播、有声书、播客,不想每次真人重录的人
- 想搞明白语音模型怎么训练、怎么部署的技术爱好者
需要一台能上网的电脑,云端部署那节还要租一台带 GPU 的服务器
课程目录
- 课程介绍&基础概念入门
- 声音克隆—3秒极速复刻
- 模型预训练
- 云端部署 Cosyvoice
课程用到的软件和模型文件放在本页资源区
本文隐藏内容
已解锁- 本文标题
- AI声音克隆全流程实操,3秒极速复刻、模型预训练、Cosyvoice云端部署
- 本文作者
- AFeng
- 来源平台
- 资速达 (zisuda.com)
- 本文链接
- https://www.zisuda.com/cosyvoice-voice-cloning-3-second-clone-pretraining-cloud-deployment
版权声明:本站所有资源均来自互联网公开分享或原创整理,仅供个人学习、技术交流与研究测试使用,版权归原作者所有
免责条款:任何个人或组织不得将本站资源用于商业用途。如无意中侵犯了您的知识产权或合法权益,请通过邮件(itsafeng@gmail.com)联系我们,我们将在收到通知并核实后第一时间进行删除下架处理